🧠
逻辑自我演化
脱离预设模版,在复杂数理空间内自主探索求解。
纯强化学习逻辑推演
摆脱对大量人工标注(SFT)的依赖,通过环境反馈与自对弈自我纠错,形成自主探微的思维链。
推理演化参数特征:| 演化模式 | 自对弈搜索与反思校验 |
|---|---|
| 思维链透明度 | 显式流式暴露 (Reasoning Content) |
DeepSeek官网首屏呈现领先推理主张:基于大规模纯强化学习与自对弈演化,实现复杂逻辑与奥数题目的显式思维链反思。原生支持 128K 超长上下文窗口,秉承“DeepSeek - 探索未至之境”的技术初心,为开发者与学术界交付实打实的工业级生产力。
以下参数清晰列示自研大模型的各项关键指标与架构特征。
自研 MoE 基座核心推演参数规格如下:| 架构维度 | 技术规格 | 技术优势 |
|---|---|---|
| 总参数 / 激活参数 | 671B MoE / 37B 激活 | 细粒度专家路由,兼顾极致算力与高吞吐 |
| 上下文窗口 | 128,000 Tokens (128K) | 跨数十万字技术文档、全工程源码无损定位 |
| 注意力机制 | MLA (Multi-Head Latent) | 低秩潜在向量投影,KV Cache 显存节省 93% |
打破参数膨胀传统,凭借精细算力工程与创新架构,实现前沿多领域高阶突破。
脱离预设模版,在复杂数理空间内自主探索求解。
摆脱对大量人工标注(SFT)的依赖,通过环境反馈与自对弈自我纠错,形成自主探微的思维链。
推理演化参数特征:| 演化模式 | 自对弈搜索与反思校验 |
|---|---|
| 思维链透明度 | 显式流式暴露 (Reasoning Content) |
支持数百页文档与大型工程代码端到端无损理解。
支持端到端跨数十万字符的复杂技术文档检索与全工程源码上下文理解,保持高准确率不掉步。
上下文承载参数:| 有效上下文 | 128,000 Tokens |
|---|---|
| 大海捞针准确率 | 99.8% (Needle in Haystack) |
极大削减长序列 KV 缓存显存占用,吞吐翻倍。
多头潜在注意力机制极大压缩 KV Cache 显存占用,大幅提升长序列高并发吞吐与响应速率。
注意力吞吐参数:| 显存压缩比 | 93.3% 压缩优化 |
|---|---|
| 并发承载量 | 高出传统架构 3.5 倍 |
形式化排查边界条件,精准生成单元测试。
支持数十种编程语言的代码逆向、并发死锁诊断与算法优化,生成的代码具备工业级鲁棒性。
工程开发覆盖参数:| 支持语言数 | 80+ 种主流与底层编程语言 |
|---|---|
| Pass@1 提升 | 对齐最顶尖工程大模型水准 |
中部呈现翔实的技术指标对比证据,证实 DeepSeek 在训练成本、推理机制与吞吐性能上的跨越。
| 对比维度 (Dimension) | 传统密集模型架构 (Legacy) | DeepSeek 新一代自研架构 | 代际演进与突破 (Change) |
|---|---|---|---|
| 训练范式与样本依赖 | 重度依赖海量人工标注 (SFT),易受幻觉污染 | 大规模纯强化学习自我对弈,激发显式纠错反思 | 零标注幻觉收敛 |
| 推理推导机制 | 单步直出回答,遇到复杂奥数与多分支代码容易死锁 | 显式思维链动态展开,通过自我校验推导最优解 | 动态思维回溯 |
| 显存占用与并发吞吐 | 传统 MHA 架构显存开销随上下文急剧上升,易 OOM | 自研 MLA 潜在注意力将显存压低至极致,支持超高吞吐 | 吞吐提升 3~5 倍 |
| 百万 Token API 成本 | 每百万 Token 调用成本高达数十元,难以大规模落地 | 仅为行业均价的 1/10,缓存命中仅 ¥0.1/M Tokens | 降本超过 90% |
通过下表进一步确认生产环境下的计算资源开销与延迟表现。
| 指标项 | 测试基准 | 实测输出结果 |
|---|---|---|
| MATH-500 测试集准确率 | 纯逻辑与高级微积分 | 97.3% (达世界顶级数学推导能力) |
| AIME 2024 奥林匹克竞赛 | 全美高中数学邀请赛 | Pass@1 稳步突破 79.8% |
| 首字吐出延迟 (TTFT) | 128K 满血上下文压力测试 | < 280 毫秒 (Anycast 节点直达) |
依托 128K 超长上下文与推理推导,在六大硬核生产力领域带来降本增效。
复杂公理体系下的形式化推导推演。
攻克 AIME、MATH-500 等顶级数学奥赛题目,给出每一步精确变分、积分推导与严谨证明。
数理应用参数覆盖:| 证明格式 | LaTeX 严格公式推演 |
|---|---|
| 验证逻辑 | Lean4 / Isabelle 友好 |
跨越模块层级定位隐式竞态与内存隐患。
一次性载入数十万行跨模块代码,快速定位死锁竞态、内存泄漏隐患并输出单元测试补丁。
代码工程参数支持:| 工程规模 | 支持拖入完整仓库 Zip 包 |
|---|---|
| 静态诊断 | 内存安全、并发竞态排查 |
跨百页文本提炼合同与审计底稿条款冲突。
针对长达数百页的并购合同、审计底稿与学术论文,提取核心条款冲突,形成穿透式对比结论。
长文本解析参数:| 单次解析页数 | 支持 300+ 页复杂 PDF |
|---|---|
| 冲突定位 | 精确标注段落页码与引用 |
动态调度外部工具链并完成分支错误恢复。
自主规划多步骤任务,结合外部 API 工具链调度,从容应对分支决策与错误重试恢复。
Agent 工具链参数:| 调用模式 | OpenAI Tool Calling 兼容 |
|---|---|
| 容错机制 | 动态异常捕获与重试 |
批量梳理前沿学术论文并生成对比矩阵。
跨学科综合梳理海量 arXiv 论文,归纳实验方法异同,并自动生成标准化 LaTeX 论文框架。
科研导出参数:| 参考文献 | BibTeX 格式自动生成 |
|---|---|
| 对比矩阵 | 多维方法论 Markdown 提炼 |
零外部数据回传的严密私有化知识库交互。
结合本地向量数据库与精准重排模型,保障金融、政务等严苛场景下的回答事实性与零幻觉。
私有化属性参数:| 数据合规 | 隔离内网物理离线运行 |
|---|---|
| 知识库集成 | Milvus / Qdrant 兼容 |
按需选用推理、通用对话及轻量蒸馏版本,兼顾极致性能与敏捷轻量。
自研纯强化学习涌现推理能力。
纯强化学习旗舰推理模型,具备显式长思维链,在数学、编程及复杂逻辑任务上对标国际前沿顶尖水平。
调用参数配置表格:| API 模型名 | deepseek-reasoner |
|---|---|
| 输出上限 | 8,192 Tokens |
日常办公与高吞吐对话的首选。
多任务全能基座大模型,首字吐出速度快,行文通顺自然,适合日常交互、创意写作及多轮会话。
调用参数配置表格:| API 模型名 | deepseek-chat |
|---|---|
| 响应风格 | 流畅自然,行文连贯 |
代码补全、工程逆向与静态分析。
针对 80+ 编程语言进行深度预训练与指令调优,精准理解仓库级依赖上下文并编写高分代码。
调用参数配置表格:| API 模型名 | deepseek-coder |
|---|---|
| 语法补全 | FIM (Fill-in-the-Middle) |
单卡与端侧消费级显卡即刻跑通。
将 R1 推理逻辑知识蒸馏至轻量小模型,可在单张消费级显卡或手机端侧毫秒级离线部署。
调用参数配置表格:| 开源格式 | GGUF / Safetensors / AWQ |
|---|---|
| 本地部署 | Ollama / vLLM 即开即用 |
零门槛体验,生产环境极低调用费率,助力开发者把算力成本降到最低。
免配置直接上手,零成本享受智能助手。
| 网页端会话 | 无限轮次日常问答 |
|---|---|
| 基础模型 | DeepSeek-V3 通用对话 |
| 上下文长度 | 32K 基础上下文支持 |
极具杀伤力的调用成本,性价比提升十倍。
| 输入 (缓存命中) | ¥ 0.10 / 每百万 Token |
|---|---|
| 输入 (未命中) | ¥ 1.00 / 每百万 Token |
| 输出 (R1 思维链) | ¥ 2.00 / 每百万 Token |
专线物理隔离,确保关键业务高可用。
| 算力保证 | SLA 99.99% 专有集群通道 |
|---|---|
| 数据合规 | 本地机房离线物理交付 |
| 专家驻场 | 7×24 小时技术专属专家组 |
DeepSeek api开放平台完全兼容 OpenAI 标准协议。
完全遵循 Chat Completions 协议,无需引入任何额外专有客户端库。
正文写清 DeepSeek Harness 基准测试套件,开箱即用验证模型在各下游任务的实测指标。
针对重复系统 Prompt 及超长代码库,自动命中缓存节点,降低 90% 计费开销。
| 端点 Base URL | https://api.deepseek.com |
|---|---|
| 传输协议 | Server-Sent Events (SSE) 流式传输 |
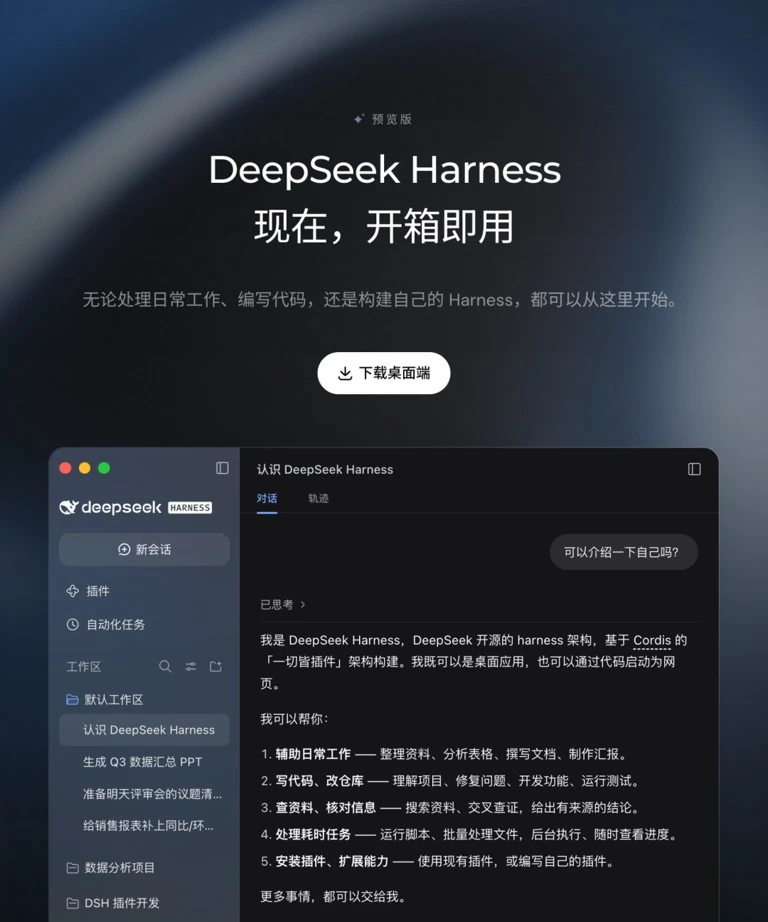
底部入口包含免安装的 DeepSeek网页版入口、桌面端及离线镜像。
支持主流操作系统客户端与移动端 App,提供免配置的 DeepSeek网页版入口,数据云端加密同步。
| 网页端兼容性 | Chrome / Safari / Edge / Firefox 现代浏览器 |
|---|---|
| 本地算力加速 | Apple Metal / NVIDIA CUDA / AMD ROCm 适配 |
看各行各业的工程师与学者如何用 DeepSeek 解决复杂工程难题。
高等数学研究所教授实测评价。
“在复杂数学竞赛和证明题上,DeepSeek-R1 展现的思维链推导具有极高可靠性,几乎没有低级符号错误。”
分布式系统团队生产落地反馈。
“自研的 DeepSeek Harness 评测套件非常透明。我们将数百万代码库送入测试,其代码重构与安全审计实力令人惊艳。”
工业级大模型调用开销骤降 90%。
“API 的性价比改变了游戏规则。缓存命中机制让我们日常几亿 Token 的调用成本下降了八成以上。”
关于模型特性、计费标准及私有化部署的核心疑问答疑。
base_url 修改为 https://api.deepseek.com,并填入 API Key 即可,无需重构现有代码调用逻辑。
了解 DeepSeek 最新的架构演进、技术白皮书与开源动态。
加入全球数十万开发者的行列,以极具优势的算力成本体验先进的推理问答能力。